AI 이해하기 6편 · 모아의 기웃기웃
1편 · 학습의 원리 → 2편 · 최적화 → 3편 · 신경망 → 4편 · 과적합과 일반화 → 5편 · 데이터 품질 → 6편 · CNN
사진을 보고 ‘여기에 선이 있다’고 느끼는 일은 우리에게 자연스럽습니다. 그렇다면 밝기를 나타내는 숫자만 받는 AI는 어떻게 사진 속 무늬를 알아볼까요?
지난 글에서는 라벨·불균형·증강·분할처럼 학습 데이터를 준비하는 방법을 살펴봤습니다. 이번에는 준비한 사진에서 특징을 계산하는 CNN, 합성곱 신경망으로 들어가 보겠습니다.
핵심은 작은 필터를 여러 위치에 같은 방식으로 적용하는 것입니다. 주변 픽셀과 필터의 숫자를 짝지어 곱하고, 그 결과를 더해 특징 지도의 한 칸을 만듭니다.
네이버 본문에서는 링크를 눌러 별도 페이지에서 조작합니다. 실험의 8×8 입력은 직접 만든 합성 픽셀 그림이며 실제 검사 사진이 아닙니다. 필터도 원리를 보여주기 위해 정한 값입니다. 뒤에서 소개하는 MNIST 모델의 구조 수치는 공식 Keras 예제에 공개된 값입니다.
1. 사진은 숫자 격자다
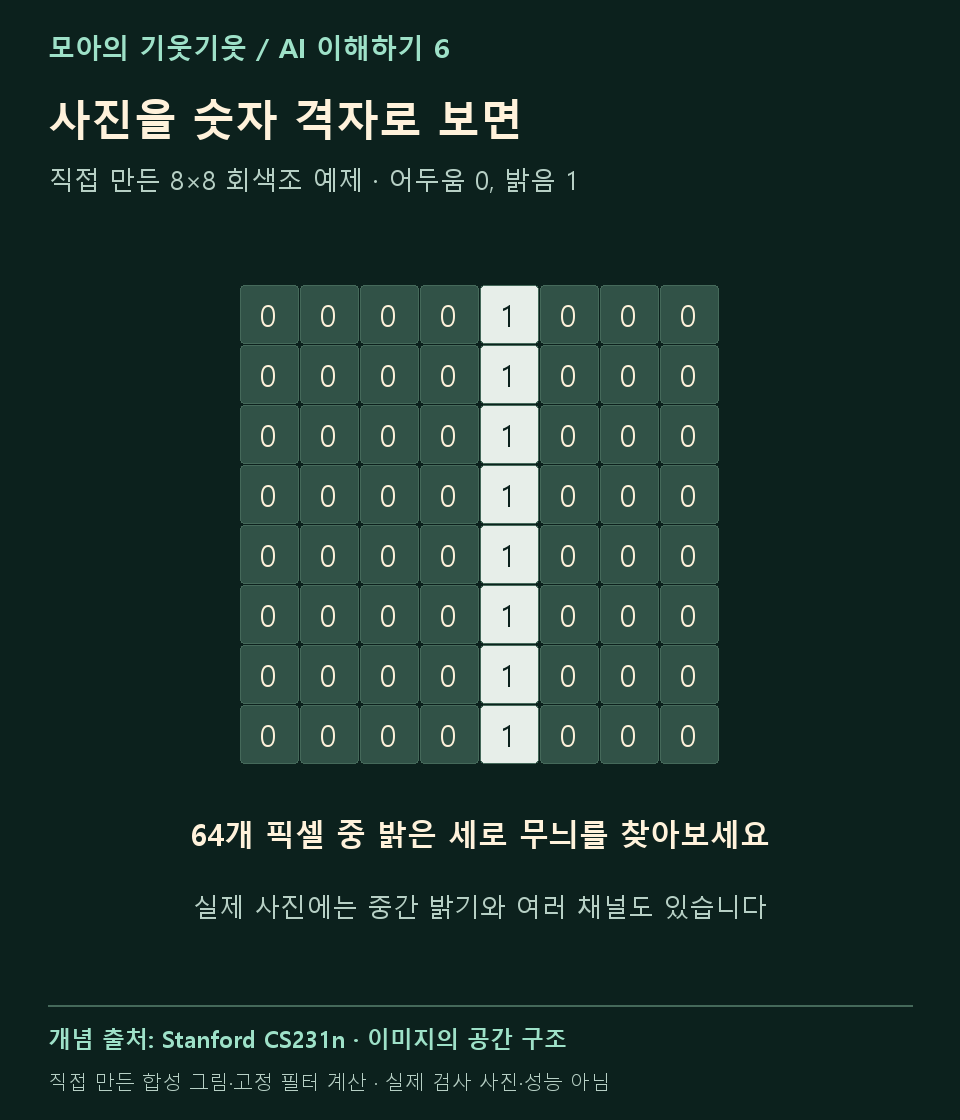
회색조 사진은 각 위치의 밝기를 숫자로 나타낼 수 있습니다. 이번 실험에서는 이해하기 쉽도록 어두운 칸을 0, 밝은 칸을 1로 둡니다. 실제 사진에는 중간 밝기도 있고, 컬러 사진에는 보통 빨강·초록·파랑의 세 채널이 있습니다.
이미지를 한 줄로 펴서 신경망에 넣는 방법도 가능합니다. 펼치는 것만으로 원래 픽셀값이 없어지는 것은 아닙니다. 다만 일반적인 완전연결층은 ‘가까운 픽셀을 함께 본다’거나 ‘서로 다른 위치에서 같은 필터를 쓴다’는 구조를 자동으로 갖지는 않습니다.
CNN은 이런 성질을 구조에 넣습니다. 작은 영역에서 값을 계산하고 같은 필터를 다른 위치에도 반복해서 적용합니다. 사진의 공간적 관계를 활용하는 방식입니다. 개념 출처: Stanford CS231n 합성곱층
2. 3×3 필터는 아홉 번 곱하고 더한다
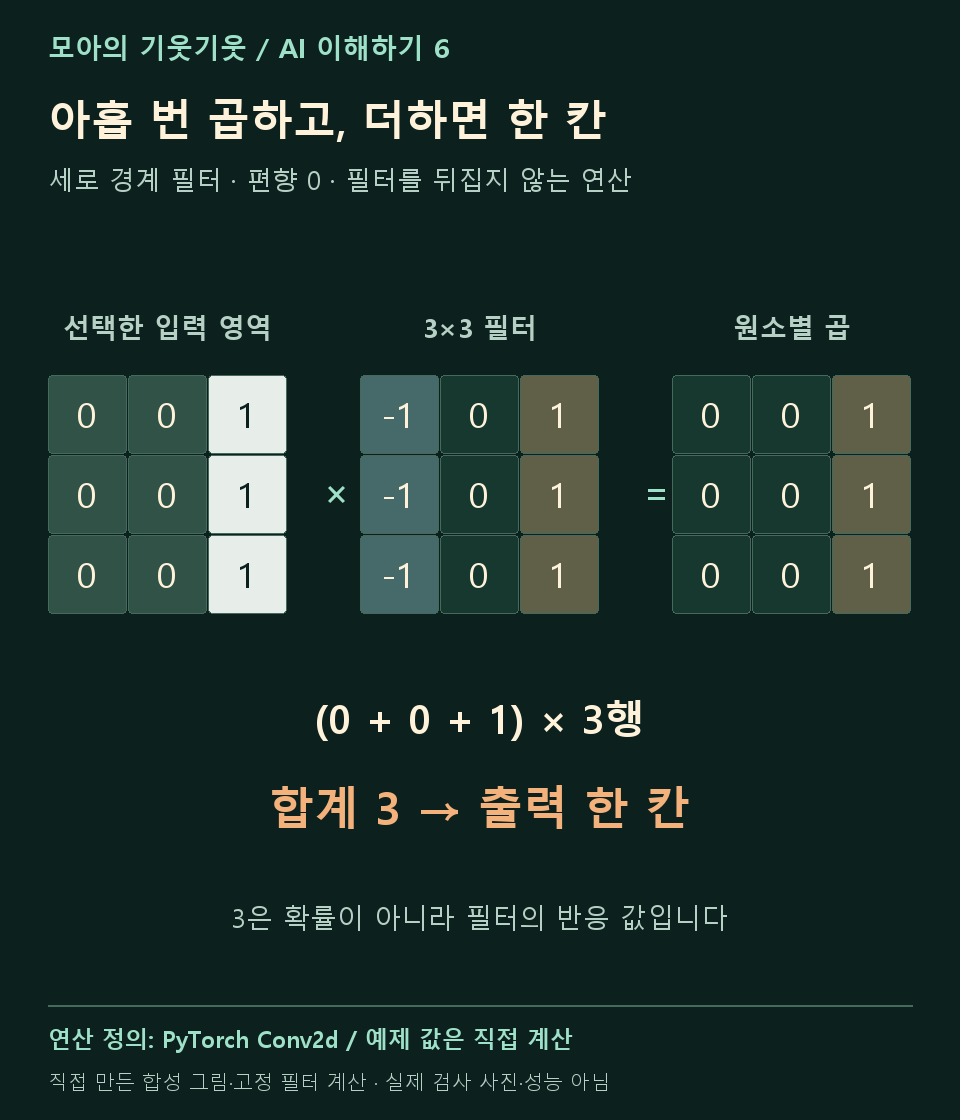
필터 또는 커널은 작은 숫자 격자입니다. 3×3이면 계수가 아홉 개입니다. 이 격자를 입력 그림의 한 영역에 겹치고, 같은 위치끼리 곱한 값을 모두 더합니다. 실제 합성곱층에는 편향을 더할 수도 있지만 이번 실험의 편향은 0으로 고정했습니다.
예를 들어 선택한 입력 영역의 각 행이 [0, 0, 1], 세로 경계 필터의 각 행이 [−1, 0, 1]이라면, 한 행의 계산은 0×(−1)+0×0+1×1=1입니다. 이런 행이 세 개라서 합계는 3입니다.
이 숫자 3이 출력 격자의 한 칸에 들어갑니다. 사진 전체에 대한 ‘불량 확률 3’이라는 뜻은 아닙니다. 선택한 필터가 그 위치의 픽셀에 보인 수치적 반응입니다.
엄밀한 용어로, 실험은 필터를 뒤집지 않고 계산하는 교차상관을 사용합니다. 딥러닝의 합성곱층에서도 사용하는 방식이며 PyTorch 공식 문서에 명시돼 있습니다. 이 글에서는 관례에 따라 합성곱이라고 부릅니다. 연산 정의 출처: PyTorch Conv2d
3. 필터가 이동하면 특징 지도가 생긴다
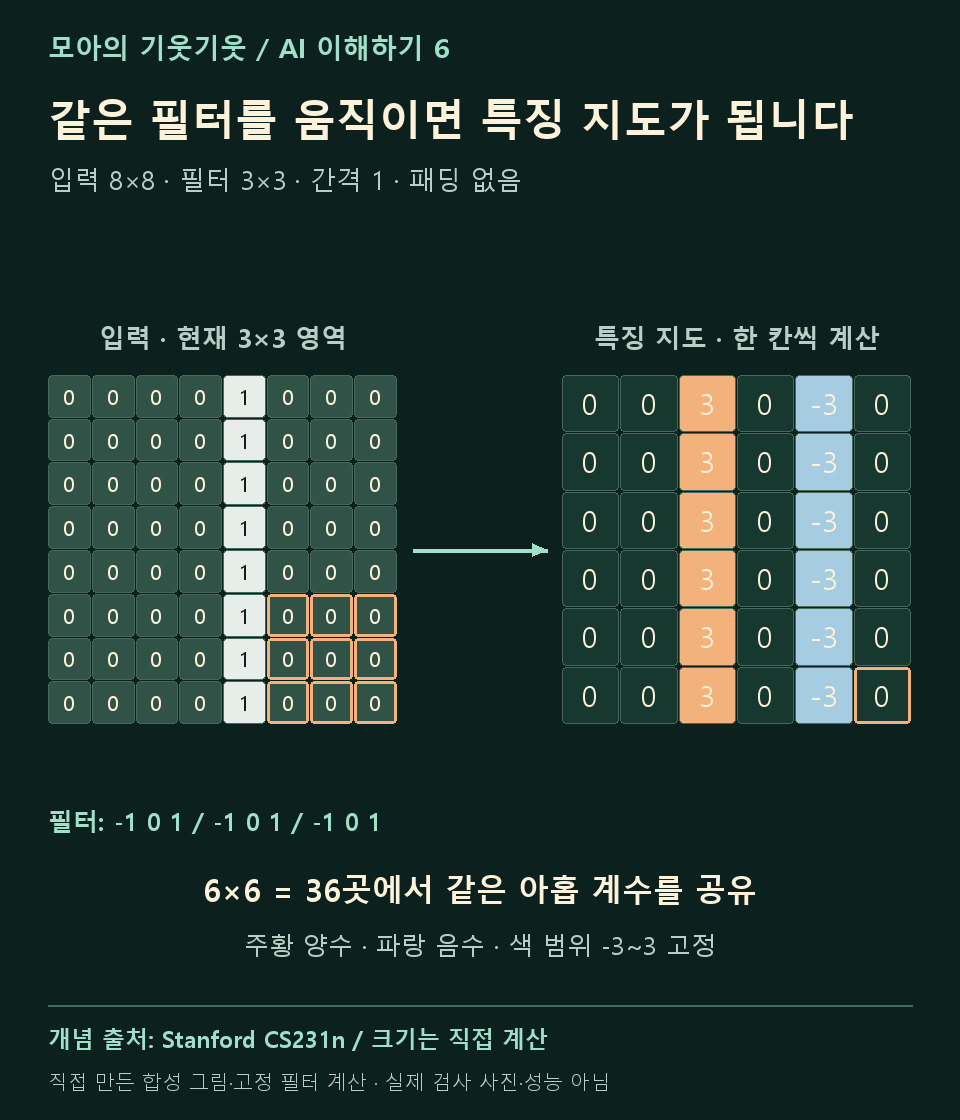
첫 위치에서 계산을 마치면 필터를 옆으로 한 칸 옮겨 같은 계산을 합니다. 한 줄을 마치면 다음 줄로 이동합니다. 각 위치의 결과를 모은 격자가 특징 지도, feature map입니다.
기본 설정은 8×8 입력, 3×3 필터, 이동 간격 1, 패딩 없음입니다. 필터가 입력 밖으로 나가지 않게 움직이면 가로·세로 각각 6곳에 놓입니다. 따라서 출력은 6×6, 총 36칸입니다. 이는 실험의 조건에서 직접 계산한 값입니다.
중요한 점은 36곳마다 새로운 필터를 따로 만드는 것이 아니라, 같은 아홉 계수를 반복해 사용한다는 것입니다. 이를 가중치 공유라고 합니다. 실제 1채널 입력·1출력 필터에 학습 가능한 편향까지 두면 파라미터는 9+1=10개입니다. 이 실험에서는 그 값들을 고정하고 학습은 수행하지 않습니다.
세로 경계 필터는 왼쪽과 오른쪽의 밝기 차이에 반응합니다. 같은 밝기 경계라도 방향에 따라 양수 또는 음수가 나올 수 있습니다. 애니메이션은 양수를 주황, 음수를 파랑으로 표시하며 색 범위를 −3~3으로 고정했습니다. 아직 계산하지 않은 칸은 점으로 구분합니다.
평균 흐림 필터를 고르면 주변 아홉 값을 평균냅니다. ‘그대로 보기’는 가운데 픽셀만 통과시킵니다. 이 비교로 필터의 숫자가 결과를 바꾼다는 것을 확인할 수 있습니다.
4. 패딩·스트라이드·ReLU는 각각 다른 일을 한다
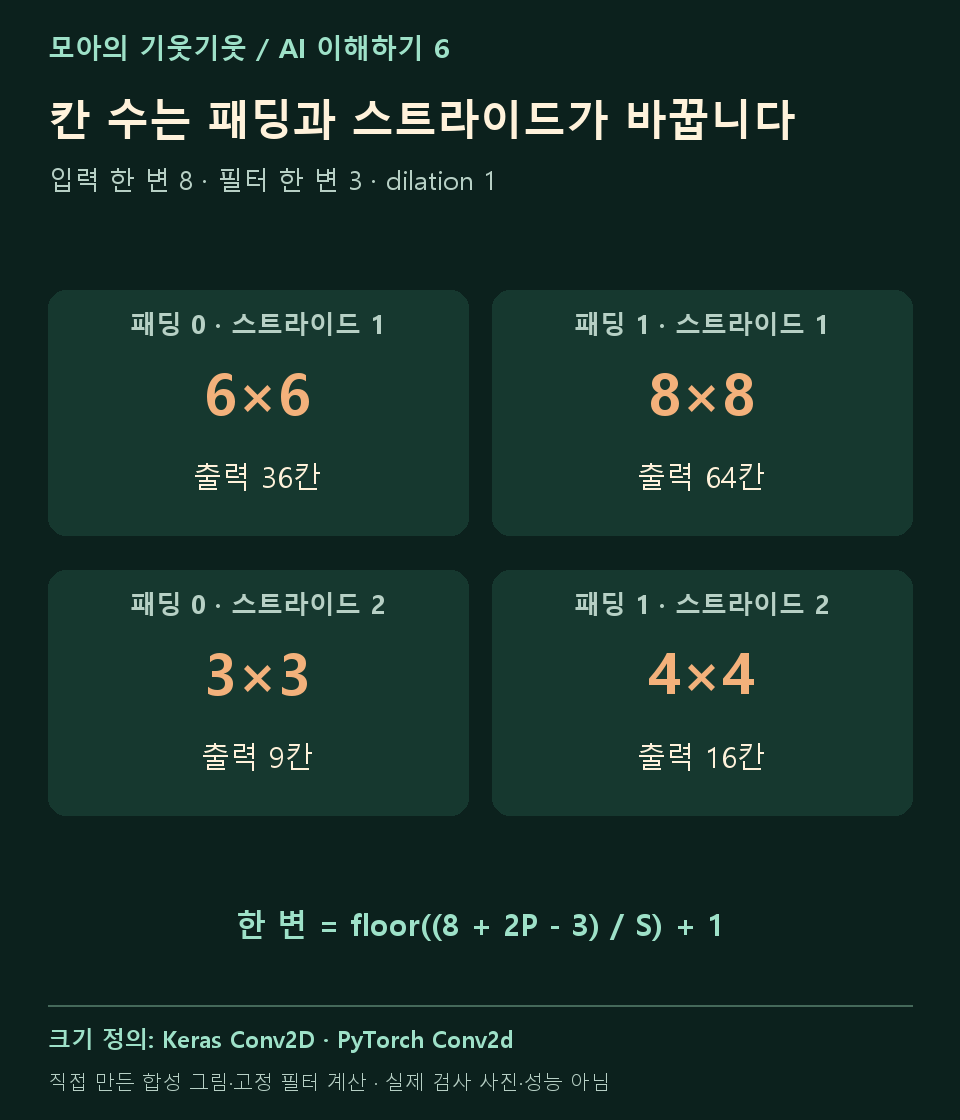
패딩은 입력 가장자리에 값을 덧대는 것입니다. 실험에서 패딩 1을 고르면 사방에 0을 한 칸씩 추가합니다. 0은 실제로 촬영한 주변 밝기가 아니라 계산을 위한 경계 조건입니다.
스트라이드는 필터가 한 번에 움직이는 칸 수입니다. 1이면 한 칸씩, 2이면 두 칸씩 이동합니다. 간격을 키우면 출력 위치가 줄어듭니다.
| 8×8 입력·3×3 필터 | 출력 크기 | 출력 칸 수 |
|---|---|---|
| 패딩 0·스트라이드 1 | 6×6 | 36 |
| 패딩 1·스트라이드 1 | 8×8 | 64 |
| 패딩 0·스트라이드 2 | 3×3 | 9 |
| 패딩 1·스트라이드 2 | 4×4 | 16 |
한 변의 크기는 ⌊(입력 크기+2×패딩−필터 크기)÷스트라이드⌋+1로 계산했습니다. 위 표는 필터 내부 간격을 늘리는 dilation이 1이고, 양쪽에 같은 크기의 패딩을 넣는 조건입니다. ‘패딩 1’과 라이브러리의 ‘same’은 모든 설정에서 같은 말이 아닙니다. 크기 조건 출처: Keras Conv2D
ReLU는 음수를 0으로 바꾸고 양수는 유지하는 활성화 함수입니다. ‘판정’ 버튼이 아니라 값을 변환하는 단계입니다. 실험에서 켜면 −3은 0이 되고 3은 그대로 남습니다. 출력 격자의 가로·세로 크기는 바뀌지 않습니다.
간격을 늘리거나 크기를 줄이면 작은 특징의 표현과 위치 정보가 달라질 수 있습니다. 출력이 작아졌다는 이유만으로 성능이 좋아졌다고 판단할 수는 없습니다.
5. 실제 CNN은 필터를 학습한다: 공식 MNIST 예제
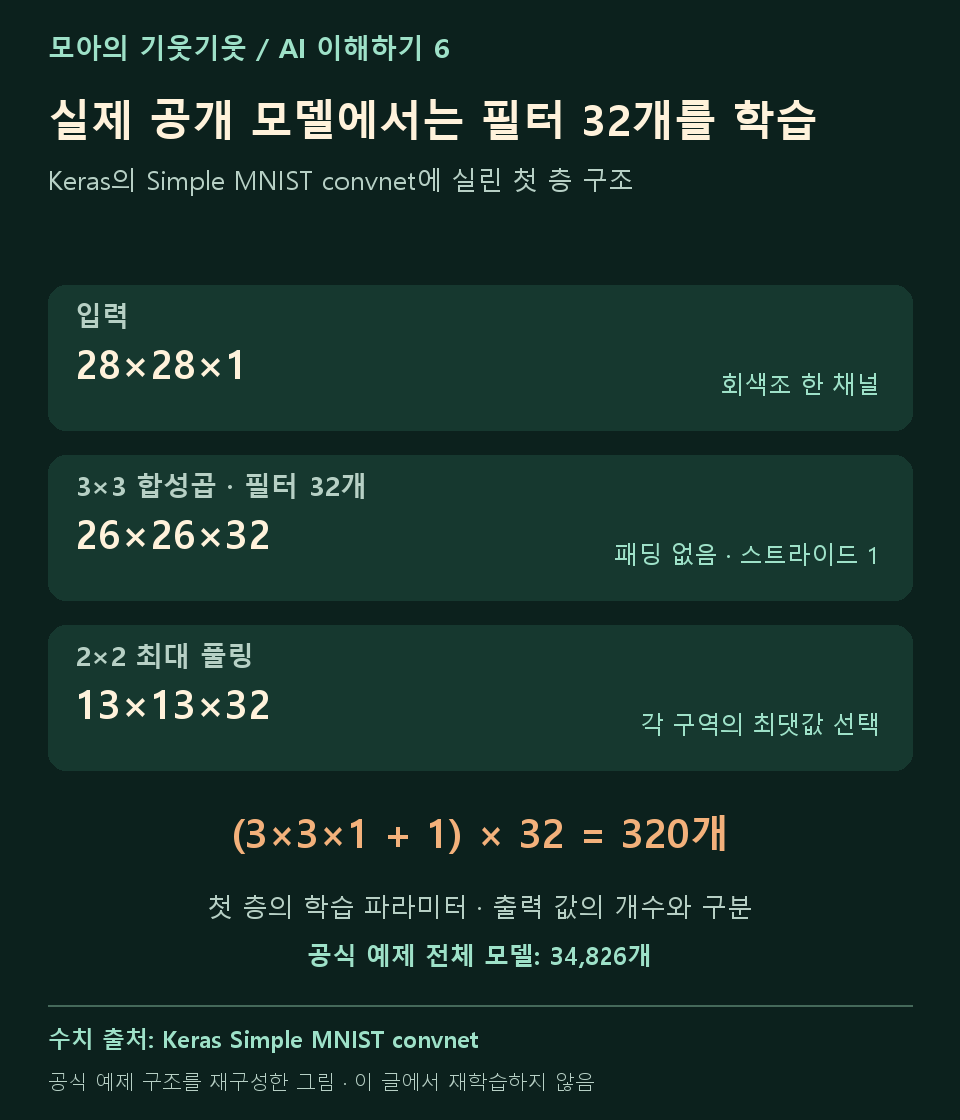
여기까지는 사람이 정한 필터를 비교했습니다. 실제 CNN 학습에서는 예측 오차를 줄이도록 필터 계수와 편향을 데이터에서 조정합니다. 고정된 경계 필터만으로 CNN 학습 전체를 대신할 수는 없습니다.
앞 글에서 소개한 MNIST는 손글씨 숫자 데이터입니다. Keras의 공식 예제는 28×28 회색조 입력에 3×3 필터 32개를 쓰는 첫 층을 제공합니다. 패딩을 넣지 않는 이 층의 출력은 26×26×32이며, 학습 파라미터는 320개입니다.
320은 (3×3×입력 채널 1+편향 1)×출력 채널 32로 계산됩니다. 필터 32개가 서로 다른 계수를 가질 수 있어 특징 지도도 32장 생깁니다. 26×26×32=21,632개의 출력 값과, 학습으로 조절하는 파라미터 320개는 서로 다른 개수입니다.
| 공식 예제의 구간 | 출력 모양 | 파라미터 수 |
|---|---|---|
| 입력 | 28×28×1 | 없음 |
| 첫 3×3 합성곱, 필터 32개 | 26×26×32 | 320 |
| 2×2 최대 풀링 | 13×13×32 | 0 |
| 두 번째 3×3 합성곱, 필터 64개 | 11×11×64 | 18,496 |
공식 예제는 이후 풀링·펼치기·드롭아웃·분류층을 더하며 전체 파라미터는 34,826개입니다. 입력 채널과 출력 채널이 바뀌면 필터의 계수 수도 바뀝니다. ‘3×3 필터니까 항상 파라미터가 아홉 개’라고 외우면 안 되는 이유입니다.
이 표는 공식 문서에 실린 모델 구조이며 이 글에서 다시 학습한 결과는 아닙니다. MNIST의 분류 성능을 실제 제품의 불량 검출 성능으로 바꾸어 읽을 수도 없습니다. 실제 구조·수치 출처: Keras Simple MNIST convnet
6. 층이 깊어지면 참고하는 범위가 넓어진다
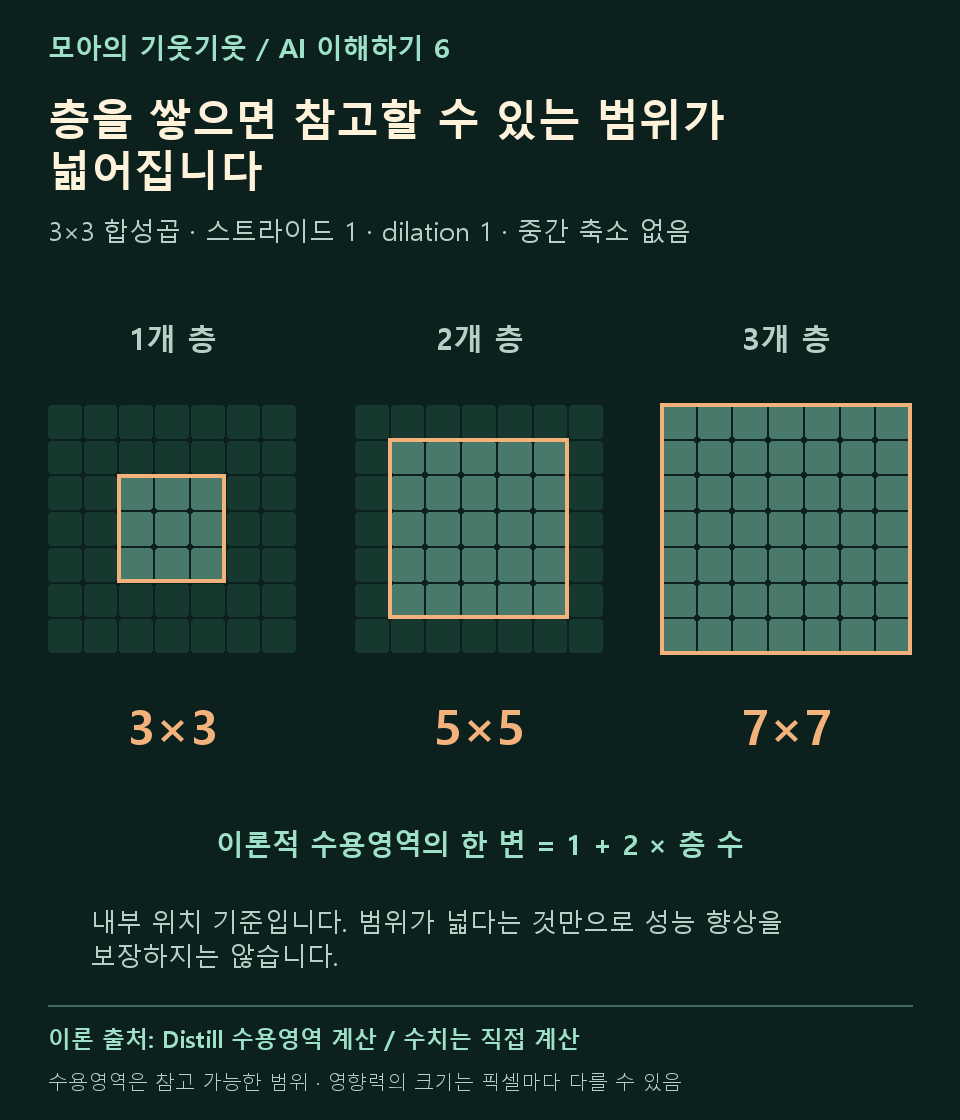
첫 층의 한 칸은 원본의 작은 영역을 참고합니다. 다음 층이 앞 층의 여러 칸을 다시 함께 보면, 원본에서 영향을 받을 수 있는 범위가 넓어집니다. 이를 수용영역, receptive field라고 부릅니다.
3×3 합성곱, 스트라이드 1, dilation 1이고 중간에 크기를 줄이는 연산이 없다면, 내부 위치의 이론적 수용영역은 한 층에서 3×3, 두 층에서 5×5, 세 층에서 7×7입니다. 직접 계산하면 한 변은 1+2×층 수입니다. 가장자리의 패딩 영역에는 실제 이미지 정보가 없습니다.
수용영역은 참고할 수 있는 범위입니다. 그 안의 모든 픽셀을 같은 정도로 활용한다거나, 층을 늘리면 항상 성능이 좋아진다는 뜻은 아닙니다. 이론 출처: Distill 수용영역 계산
크기를 줄이는 대표적인 연산인 2×2 최대 풀링은 각 2×2 구역에서 최댓값 하나를 남깁니다. 스트라이드 2·패딩 없음이라면 6×6은 3×3으로 줄어듭니다. 합성곱이 가중합을 계산하는 것과 달리 최대 풀링 자체에는 학습할 필터 계수가 없습니다. 정의 출처: Keras MaxPooling2D
7. 애니메이션은 이렇게 확인해 보세요
- 기본 ‘세로 무늬·세로 경계’에서 재생을 누릅니다. 입력 위의 3×3 테두리와 출력의 현재 칸이 함께 이동합니다.
- 진행 슬라이더를 3번째 칸으로 옮깁니다. 아홉 곱셈과 합계 3이 연결되는지 확인합니다. 이후 음수가 나오는 칸도 살펴보세요.
- 무늬 위치를 바꿉니다. 같은 필터를 다른 위치에 적용한 결과를 봅니다. 위치를 옮겨도 전체 분류 결과가 반드시 같아진다는 실험은 아닙니다.
- 가로 무늬와 가로 경계 필터를 조합하고, 평균 흐림 필터와도 비교합니다.
- 세부 조건을 펼쳐 패딩·스트라이드·ReLU를 바꿉니다. 출력 모양과 값 중 무엇이 바뀌는지 구분합니다.
56초 · 한국어 자막 · 음성 없음
영상은 한국어 자막으로 구성했으며 음성은 없습니다. 글·그림·실험·영상의 기본 예제는 같은 입력과 필터 계수를 사용합니다.
데이터 품질 편이 ‘좋은 연습 문제를 어떻게 준비할까’였다면, 이번 편은 ‘사진에서 어떤 계산을 할까’입니다. 다음에는 이 특징을 이용해 사진 전체를 분류하는 것과 물체의 위치·모양을 찾는 것이 어떻게 다른지 이어갈 수 있습니다.
출처와 제작 기준
자료 확인: 2026년 11월 22일. 공식 문서의 모델 구조와 직접 계산한 교육용 예제를 구분했습니다. 그림 6장과 영상은 직접 제작한 개념도이며 실제 검사 사진·현장 성능·학습된 결함 판정 결과가 아닙니다.
#CNN #합성곱 #합성곱신경망 #특징지도 #이미지인식 #컴퓨터비전 #딥러닝기초 #AI공부 #필터 #MNIST #AI이해하기 #모아의기웃기웃